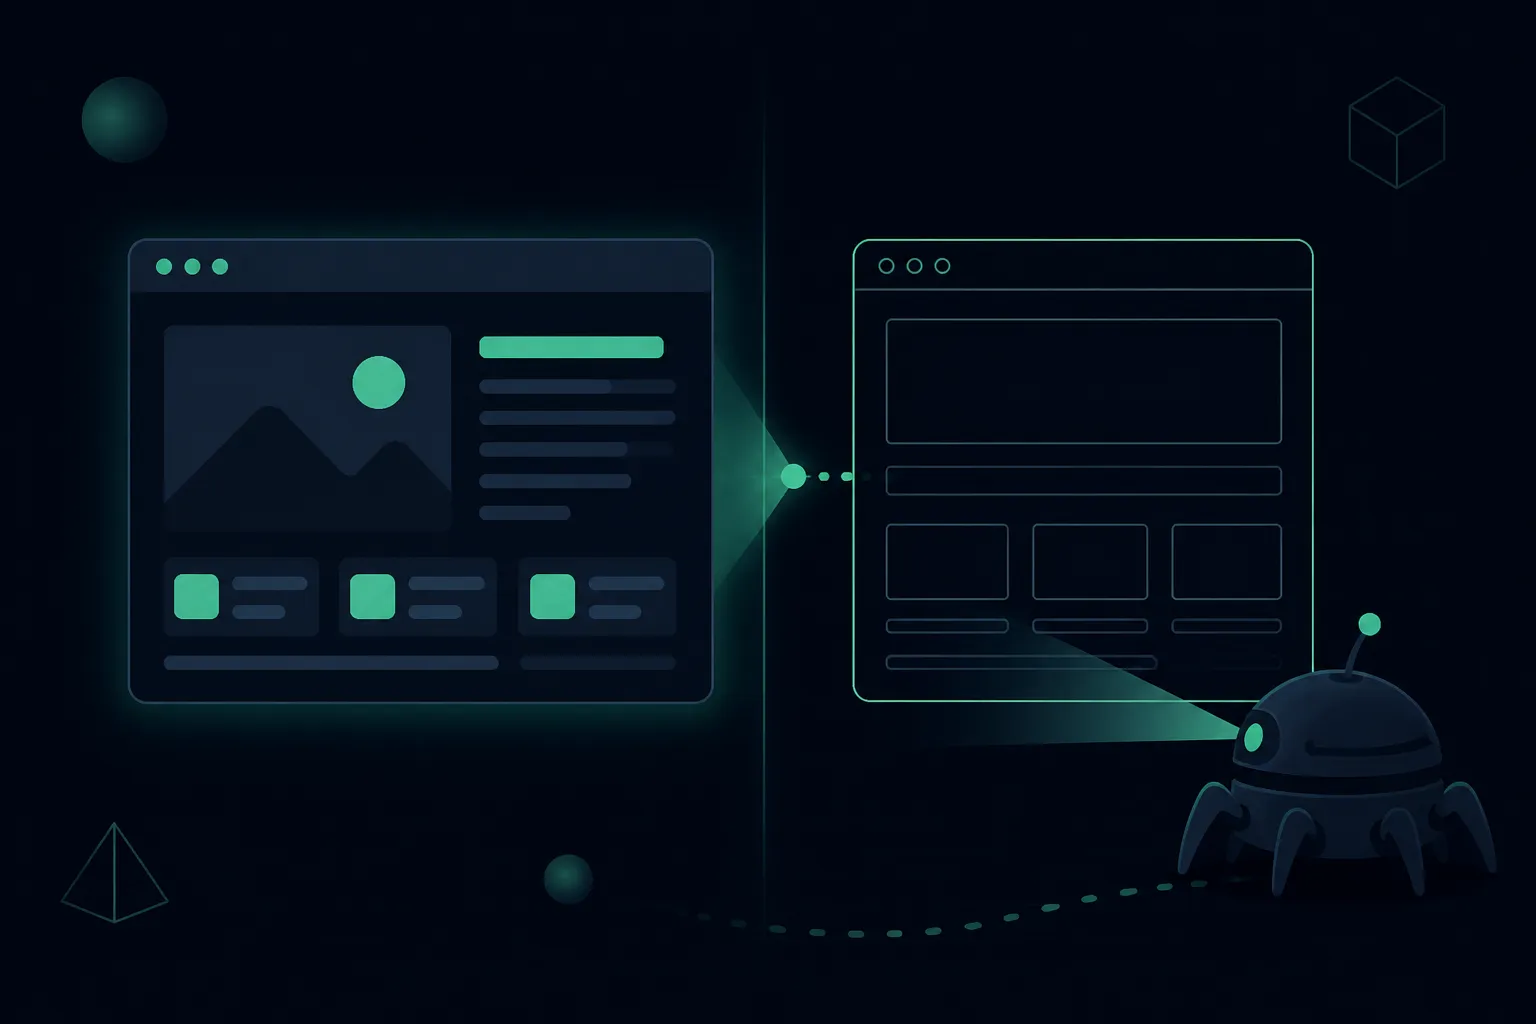
เว็บของคุณดูปกติดีในเบราว์เซอร์ นั่นไม่ได้พิสูจน์อะไรเลยว่า AI เห็นอะไรบ้าง เพราะเบราว์เซอร์ทำสิ่งที่ AI crawler จำนวนมากไม่ทำ นั่นคือการรัน JavaScript
ช่องว่างที่เกิดขึ้น
เว็บยุคใหม่จำนวนมากส่ง HTML ที่แทบว่างเปล่า พร้อม JavaScript ที่สร้างหน้าเว็บขึ้นในเบราว์เซอร์ของผู้เข้าชม คนทั่วไปไม่มีทางสังเกตเห็น แต่เมื่อ crawler ดึงหน้านั้นมาแล้วไม่รันสคริปต์ — และ AI crawler ที่ดึงข้อมูลในสเกลมหาศาลด้วยงบจำกัด มักไม่รัน — สิ่งที่มันอ่านได้คือเปลือกเปล่า ไม่มีหัวข้อ ไม่มีข้อความ ไม่มีราคา ไม่มีอะไรให้ยกไปอ้างอิง
Search engine แก้ปัญหานี้ไปได้บางส่วนตลอดกว่าทศวรรษที่ผ่านมาด้วย deferred rendering pipeline ระบบ AI retrieval ที่ใหม่กว่านั้นยังเด็กกว่า หิวกว่า และอดทนน้อยกว่า ข้อสันนิษฐานที่ปลอดภัยในปี 2026 คือ เนื้อหาที่ต้องพึ่ง JavaScript ถึงจะปรากฏ คือเนื้อหาที่ AI บางเอนจินอ่านไม่ได้
วิธีตรวจสอบใน 30 วินาที
เปิด terminal แล้วดึงหน้าเว็บของคุณแบบเดียวกับที่ crawler ทำ จากนั้นดูข้อความที่ได้
curl -s https://yourdomain.com/ — แล้วค้นหาในผลลัพธ์ว่ามีประโยคที่คุณรู้ว่าอยู่บนหน้านั้น เบอร์โทรศัพท์ หรือชื่อสินค้าหรือไม่
ไม่มี terminal ก็ใช้เบราว์เซอร์แทนได้ เปิดดู view page source (ไม่ใช่ element inspector ต้องเป็น raw source) แล้วค้นหาประโยคเดียวกัน ถ้าคำที่ลูกค้าของคุณอ่านไม่ปรากฏใน source นั้น เครื่องที่ข้าม JavaScript ก็อ่านคำเหล่านั้นไม่ได้เช่นกัน
ให้คะแนนตัวเองง่ายๆ คุณหา headline ราคา และข้อมูลติดต่อเจอใน HTML ดิบหรือไม่ ถ้าเจอครบทั้งสามอย่าง แปลว่าปลอดภัย ถ้าขาดอย่างใดอย่างหนึ่ง เนื้อหานั้นมองไม่เห็นบนเส้นทาง retrieval นี้
วิธีแก้ ไล่จากถูกสุด
- ใส่ข้อเท็จจริงสำคัญไว้ใน HTML ที่คุณส่งอยู่แล้ว แม้แต่เว็บที่หนัก JavaScript title tag, meta description และ structured data มักเรนเดอร์ฝั่งเซิร์ฟเวอร์อยู่แล้ว ทำให้สิ่งเหล่านี้บอกประเภทธุรกิจ พื้นที่ให้บริการ และตัวเลขสำคัญ เพื่อให้แม้ในกรณีเลวร้ายที่สุดก็ยังมีข้อมูลจริงให้อ่าน
- Pre-render ตอน build ถ้าเนื้อหาของคุณเปลี่ยนไม่บ่อย — เว็บการตลาดของ SME ส่วนใหญ่เป็นแบบนี้ — static generation ให้ HTML ที่ครบถ้วนโดยไม่มีต้นทุนเซิร์ฟเวอร์เพิ่มเติม เฟรมเวิร์กอย่าง Next, Nuxt และ Astro รองรับทั้งหมด ส่วนใหญ่แค่ปรับ configuration ไม่ต้องเขียนใหม่
- SSR หน้าที่สำคัญ หน้าแรก หน้าบริการ FAQ ส่วน dashboard และเครื่องมือโต้ตอบหลังล็อกอินปล่อยให้เป็น client-rendered ต่อไปได้ตลอด ไม่มีเอนจินไหนต้องอ่านมัน
- รื้อสร้างใหม่ — ทำเฉพาะตอนที่เว็บถึงคิวต้องรื้อสร้างอยู่แล้วเท่านั้น อย่ารื้อเว็บที่ใช้งานได้ดีอยู่เพียงเพื่อความ crawlable ได้ ข้อ 1-3 คว้าคุณค่าส่วนใหญ่ไว้แล้วด้วยต้นทุนเสี้ยวเดียว
ข้อควรระวังตามจริง
AI pipeline บางตัวรัน JavaScript จริง และขอบเขตความครอบคลุมก็เปลี่ยนไปเรื่อยๆ การทำ server-rendered HTML ไม่ได้เกี่ยวกับ crawler ตัวใดตัวหนึ่งโดยเฉพาะ มันตัดความไม่แน่นอนทั้งกลุ่มออกไป เนื้อหาของคุณอ่านได้โดยทุก fetcher ไม่ว่าจะอดทนหรือไม่ ทั้งวันนี้และปีหน้า ในสายงานที่มีการรับประกันน้อยมาก นี่คือหนึ่งในสิ่งที่ถูกที่สุดที่หาได้